

Trong thế giới dữ liệu ngày nay, việc nắm vững công thức tính mẫu số liệu là kỹ năng thiết yếu đối với bất kỳ ai quan tâm đến phân tích thông tin. Bài viết này của Gia Sư Thành Tâm sẽ giúp bạn hiểu rõ các phương pháp tính toán, từ những chỉ số cơ bản nhất đến các khái niệm phức tạp hơn, áp dụng cho cả dữ liệu thô và dữ liệu đã được ghép nhóm.
Hiểu Về Mẫu Số Liệu và Tầm Quan Trọng của Phân Tích
Mẫu số liệu đóng vai trò quan trọng trong việc đưa ra các kết luận, dự đoán và quyết định trong nhiều lĩnh vực khác nhau. Để hiểu rõ hơn về phân tích dữ liệu thống kê, trước tiên chúng ta cần làm quen với khái niệm cơ bản về mẫu số liệu và lý do tại sao việc tính toán các chỉ số từ mẫu lại vô cùng cần thiết.
Khái Niệm Mẫu Số Liệu và Ghép Nhóm
Mẫu số liệu là một tập hợp con của tổng thể được thu thập để nghiên cứu. Khi mẫu số liệu có kích thước lớn, việc xử lý từng giá trị riêng lẻ trở nên khó khăn. Lúc này, kỹ thuật ghép nhóm được sử dụng để tổ chức dữ liệu thành các khoảng hoặc lớp, giúp việc phân tích trở nên dễ dàng và trực quan hơn. Mỗi nhóm sẽ có một tần số tương ứng, cho biết số lần các giá trị trong nhóm đó xuất hiện trong mẫu. Bảng tần số ghép nhóm thường được trình bày dưới dạng các khoảng giá trị và tần số của chúng. Ví dụ, một bảng thống kê cân nặng của học sinh có thể được chia thành các nhóm như [45; 49) kg, [49; 53) kg, v.v., mỗi nhóm đi kèm với số lượng học sinh thuộc nhóm đó.
Để đơn giản hóa việc tính toán các chỉ số đo lường thống kê từ dữ liệu ghép nhóm, người ta thường sử dụng giá trị đại diện cho mỗi nhóm. Giá trị đại diện này thường là trung điểm của khoảng, ví dụ đối với nhóm [u1; u2), giá trị đại diện là (u1+u2)/2. Độ dài của mỗi nhóm, tức là hiệu giữa cận trên và cận dưới (uj+1 – uj), cũng là một thông số quan trọng cần lưu ý khi xây dựng bảng ghép nhóm. Số lượng nhóm thường dao động từ 5 đến 20, tùy thuộc vào kích thước mẫu và khoảng biến thiên của dữ liệu.
Tại Sao Cần Tính Toán Mẫu Số Liệu?
Việc tính toán các chỉ số từ mẫu số liệu không chỉ là một bài tập toán học đơn thuần mà còn là nền tảng cho mọi quyết định dựa trên dữ liệu. Những phương pháp tính toán dữ liệu này cung cấp cái nhìn sâu sắc về đặc điểm của mẫu, giúp chúng ta hiểu được xu hướng chung, mức độ phân tán, và hình dạng của phân phối dữ liệu. Chẳng hạn, một nhà quản lý muốn biết mức độ hài lòng trung bình của khách hàng, hoặc một nhà khoa học cần xác định sự biến động của một biến số trong thí nghiệm.
Các chỉ số thống kê mô tả như số trung bình, trung vị, mốt, phương sai, và độ lệch chuẩn giúp tóm tắt dữ liệu một cách hiệu quả, biến hàng ngàn điểm dữ liệu thành vài con số ý nghĩa. Điều này đặc biệt hữu ích khi cần so sánh các tập dữ liệu khác nhau hoặc đưa ra dự đoán về tổng thể mà mẫu đại diện. Nhờ các công thức tính mẫu số liệu này, chúng ta có thể chuyển đổi dữ liệu thô thành thông tin có giá trị, hỗ trợ đưa ra các quyết định sáng suốt trong mọi lĩnh vực từ kinh doanh, y tế đến giáo dục.
Công Thức Tính Các Chỉ Số Đo Lường Xu Hướng Trung Tâm
Các chỉ số đo lường xu hướng trung tâm giúp xác định giá trị điển hình hoặc vị trí trung tâm của một tập dữ liệu. Ba chỉ số phổ biến nhất là số trung bình cộng, trung vị và mốt. Mỗi chỉ số có ưu điểm riêng và được sử dụng trong các tình huống khác nhau để phản ánh chính xác nhất bản chất của dữ liệu. Việc hiểu rõ từng công thức tính mẫu số liệu này sẽ giúp bạn áp dụng chúng một cách hiệu quả.
Số Trung Bình Cộng (Mean)
Số trung bình cộng, thường được gọi đơn giản là số trung bình, là chỉ số được sử dụng rộng rãi nhất để đo xu hướng trung tâm. Đối với mẫu số liệu thô, công thức tính số trung bình là tổng tất cả các giá trị chia cho số lượng các giá trị đó. Ví dụ, nếu bạn có điểm số của 5 bài kiểm tra là 7, 8, 9, 6, 10, số trung bình sẽ là (7+8+9+6+10)/5 = 8.
Đối với mẫu số liệu đã được ghép nhóm, công thức tính mẫu số liệu cho số trung bình được ước lượng bằng cách lấy tổng của tích giữa giá trị đại diện của mỗi nhóm (c_j) và tần số tương ứng (n_j), sau đó chia cho tổng tần số (n).
x̄ = (n_1 c_1 + n_2 c_2 + … + n_k * c_k) / n
Trong đó:
- n_j là tần số của nhóm thứ j.
- c_j là giá trị đại diện của nhóm thứ j.
- n là tổng tần số (tổng số lượng quan sát).
Số trung bình rất nhạy cảm với các giá trị ngoại lai (outliers) và có thể bị lệch nếu dữ liệu không đối xứng. Ví dụ, nếu cân nặng trung bình của 25 quả cam ở lô hàng A là 161,7 gram, và ở lô hàng B là 165,1 gram, ta có thể kết luận rằng cam ở lô B có xu hướng nặng hơn.
Trung Vị (Median)
Trung vị là giá trị nằm ở chính giữa một tập dữ liệu đã được sắp xếp theo thứ tự tăng dần hoặc giảm dần. Khi số lượng giá trị là lẻ, trung vị là giá trị ở vị trí (n+1)/2. Khi số lượng giá trị là chẵn, trung vị là trung bình cộng của hai giá trị ở giữa, tại vị trí n/2 và n/2 + 1. Trung vị ít bị ảnh hưởng bởi các giá trị ngoại lai hơn so với số trung bình, làm cho nó trở thành một lựa chọn tốt khi dữ liệu có sự phân tán lớn hoặc có các điểm bất thường.
Đối với dữ liệu ghép nhóm, việc tính trung vị phức tạp hơn một chút và thường đòi hỏi xác định nhóm chứa trung vị, sau đó sử dụng công thức tính mẫu số liệu xấp xỉ dựa trên tần số và độ dài nhóm. Công thức này giúp ước lượng giá trị trung vị trong khoảng đã xác định. Trung vị đặc biệt hữu ích để phân tích thu nhập hoặc giá bất động sản, nơi có thể có một vài giá trị cực kỳ cao làm sai lệch số trung bình.
Mốt (Mode)
Mốt là giá trị xuất hiện nhiều nhất trong một tập dữ liệu. Một tập dữ liệu có thể có một mốt (đơn mốt), nhiều mốt (đa mốt), hoặc không có mốt nào nếu tất cả các giá trị đều xuất hiện với tần số bằng nhau. Mốt thường được sử dụng cho dữ liệu định tính hoặc định lượng rời rạc.
Đối với mẫu số liệu đã được ghép nhóm, mốt được ước lượng dựa trên nhóm có tần số lớn nhất, được gọi là nhóm chứa mốt. Công thức tính mẫu số liệu cho mốt (Mo) của dữ liệu ghép nhóm là:
Trong đó:
- u_m là cận dưới của nhóm chứa mốt.
- h là độ dài của nhóm chứa mốt.
- n_m là tần số của nhóm chứa mốt.
- n_{m-1} là tần số của nhóm liền trước nhóm chứa mốt.
- n_{m+1} là tần số của nhóm liền sau nhóm chứa mốt.
Chẳng hạn, trong một khảo sát về mức giá mong muốn khi mua nhà, nếu nhóm giá từ [18; 22) triệu đồng/m2 có số lượng khách hàng cao nhất (120 người), thì nhóm này chính là nhóm chứa mốt. Từ đó, áp dụng công thức tính mẫu số liệu để ước lượng mốt sẽ cho ra mức giá phổ biến nhất mà khách hàng có nhu cầu.
Mốt thể hiện giá trị phổ biến nhất và không bị ảnh hưởng bởi các giá trị ngoại lai, làm cho nó trở thành một chỉ số thống kê hữu ích khi cần xác định yếu tố thịnh hành hoặc phổ biến nhất.
Công Thức Tính Các Chỉ Số Đo Lường Độ Phân Tán
Ngoài việc hiểu xu hướng trung tâm, việc đánh giá mức độ phân tán hay biến động của dữ liệu cũng rất quan trọng. Các chỉ số đo lường độ phân tán cho biết dữ liệu trải rộng như thế nào xung quanh giá trị trung tâm. Điều này giúp cung cấp cái nhìn toàn diện hơn về cấu trúc dữ liệu và tính đồng nhất của mẫu.
Khoảng Biến Thiên (Range)
Khoảng biến thiên là chỉ số đơn giản nhất để đo lường độ phân tán, được tính bằng cách lấy giá trị lớn nhất trừ đi giá trị nhỏ nhất trong tập dữ liệu. Đây là một công thức tính mẫu số liệu cơ bản nhất, cung cấp một cái nhìn nhanh chóng về phạm vi của dữ liệu.
Ví dụ, nếu chiều cao của học sinh trong một lớp dao động từ 1m50 đến 1m80, khoảng biến thiên là 30cm. Mặc dù dễ tính và dễ hiểu, khoảng biến thiên có nhược điểm là nó chỉ phụ thuộc vào hai giá trị cực trị và không phản ánh sự phân bố của các giá trị còn lại trong tập dữ liệu. Điều này khiến nó dễ bị ảnh hưởng bởi các giá trị ngoại lai.
Phương Sai và Độ Lệch Chuẩn (Variance & Standard Deviation)
Phương sai và độ lệch chuẩn là hai chỉ số quan trọng nhất để đo lường độ phân tán của dữ liệu. Chúng cho biết mức độ các giá trị dữ liệu khác biệt so với số trung bình.
Phương sai (Variance) được tính bằng cách lấy tổng bình phương các sai lệch giữa mỗi giá trị và số trung bình, sau đó chia cho số lượng quan sát (hoặc số lượng quan sát trừ 1 đối với mẫu). Công thức tính phương sai cho mẫu thô là:
S^2 = Σ(xi – x̄)^2 / (n – 1)
Đối với dữ liệu ghép nhóm, công thức tính phương sai cũng được ước lượng dựa trên giá trị đại diện và tần số của mỗi nhóm:
S^2 = Σ(n_j * (c_j – x̄)^2) / (n – 1)
Trong đó:
- c_j là giá trị đại diện của nhóm thứ j.
- n_j là tần số của nhóm thứ j.
- x̄ là số trung bình của mẫu.
- n là tổng tần số.
Độ lệch chuẩn (Standard Deviation) là căn bậc hai của phương sai. Nó là một chỉ số dễ hiểu hơn phương sai vì nó có cùng đơn vị đo với dữ liệu gốc. Một độ lệch chuẩn nhỏ cho thấy các điểm dữ liệu có xu hướng gần với số trung bình, trong khi độ lệch chuẩn lớn cho thấy các điểm dữ liệu phân tán rộng hơn. Công thức tính độ lệch chuẩn là:
S = √S^2
Phương sai và độ lệch chuẩn là nền tảng cho nhiều phân tích thống kê nâng cao, bao gồm kiểm định giả thuyết và xây dựng mô hình. Hiểu các chỉ số đo lường độ biến động này là rất quan trọng để đánh giá độ tin cậy của các ước lượng và kết quả phân tích.
Áp Dụng Công Thức Tính Mẫu Số Liệu Trong Thực Tế
Việc nắm vững các công thức tính mẫu số liệu không chỉ giới hạn trong môi trường học thuật mà còn có ứng dụng rộng rãi trong đời sống và công việc hàng ngày. Từ việc ra quyết định kinh doanh đến các nghiên cứu khoa học, khả năng phân tích và diễn giải dữ liệu là một lợi thế lớn.
Vai Trò Trong Nghiên Cứu và Kinh Doanh
Trong lĩnh vực kinh doanh, các công thức tính mẫu số liệu giúp doanh nghiệp hiểu rõ hơn về thị trường, hành vi khách hàng và hiệu suất hoạt động. Ví dụ, bằng cách tính số trung bình doanh thu hàng tháng, doanh nghiệp có thể đánh giá hiệu quả kinh doanh. Tính mốt của các mức giá ưa thích của khách hàng giúp xác định chiến lược định giá sản phẩm tối ưu. Độ lệch chuẩn trong thời gian giao hàng có thể chỉ ra sự ổn định của chuỗi cung ứng. Một công ty xây dựng đã khảo sát khách hàng về mức giá mua nhà mong muốn, và bằng cách tìm mốt của mẫu số liệu ghép nhóm, họ có thể xác định được phân khúc giá mà khách hàng tiềm năng quan tâm nhất, từ đó điều chỉnh chiến lược phát triển sản phẩm và marketing.
Trong nghiên cứu khoa học, phân tích dữ liệu thống kê là bước không thể thiếu để kiểm định giả thuyết và đưa ra kết luận đáng tin cậy. Các nhà nghiên cứu thường xuyên sử dụng các công thức tính mẫu số liệu để mô tả đặc điểm của đối tượng nghiên cứu, so sánh các nhóm khác nhau, hoặc đánh giá mối quan hệ giữa các biến số. Ví dụ, để đánh giá chiều cao trung bình của một loại cây sau ba năm tuổi, các nhà khoa học thu thập mẫu và áp dụng các công thức để ước lượng, từ đó đưa ra nhận định về tốc độ sinh trưởng của loại cây đó.
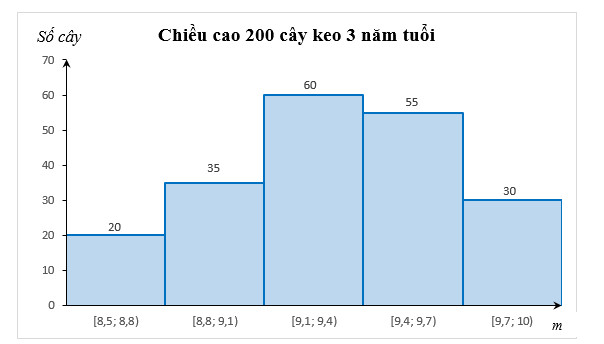 Biểu đồ tần số chiều cao cây keo
Từ biểu đồ về chiều cao 200 cây keo 3 năm tuổi, chúng ta có thể dễ dàng thấy nhóm chiều cao phổ biến nhất. Áp dụng các công thức tính mẫu số liệu để tính số trung bình và mốt sẽ cung cấp một bức tranh toàn cảnh về đặc điểm tăng trưởng của loại cây này trong điều kiện cụ thể.
Sử Dụng Phần Mềm Hỗ Trợ Phân Tích
Trong thời đại công nghệ số, việc tính toán công thức tính mẫu số liệu không còn phụ thuộc hoàn toàn vào các phép tính thủ công. Các phần mềm thống kê và bảng tính điện tử như Microsoft Excel, Google Sheets, R, Python (với các thư viện như NumPy và Pandas) đã trở thành công cụ đắc lực, giúp thực hiện các phép tính phức tạp một cách nhanh chóng và chính xác.
Những công cụ này không chỉ giúp tính toán các chỉ số thống kê mà còn hỗ trợ trực quan hóa dữ liệu thông qua biểu đồ và đồ thị, giúp người dùng dễ dàng nắm bắt các xu hướng và mối quan hệ ẩn sâu trong dữ liệu. Việc biết cách sử dụng các phần mềm này là một kỹ năng quan trọng, giúp tối ưu hóa quá trình phân tích dữ liệu thống kê và nâng cao hiệu quả công việc.
Lưu Ý Quan Trọng Khi Sử Dụng Công Thức Tính Mẫu Số Liệu
Khi áp dụng các công thức tính mẫu số liệu, có một số lưu ý quan trọng cần ghi nhớ để đảm bảo tính chính xác và ý nghĩa của kết quả. Đầu tiên, chất lượng của dữ liệu đầu vào là yếu tố then chốt. Dữ liệu không chính xác, thiếu sót hoặc có nhiều giá trị ngoại lai có thể dẫn đến các kết quả phân tích sai lệch. Do đó, việc kiểm tra, làm sạch và chuẩn bị dữ liệu kỹ lưỡng trước khi tiến hành tính toán là cực kỳ cần thiết.
Thứ hai, việc lựa chọn công thức tính mẫu số liệu phù hợp với loại dữ liệu và mục tiêu phân tích. Ví dụ, không nên dùng số trung bình cho dữ liệu có phân bố quá lệch hoặc có nhiều giá trị ngoại lai; thay vào đó, trung vị hoặc mốt có thể là lựa chọn tốt hơn. Tương tự, hiểu rõ ý nghĩa của từng chỉ số giúp bạn diễn giải kết quả một cách chính xác. Một chỉ số đơn lẻ thường không đủ để mô tả toàn bộ bức tranh của dữ liệu; kết hợp nhiều chỉ số (xu hướng trung tâm và độ phân tán) sẽ cung cấp cái nhìn toàn diện hơn. Cuối cùng, luôn cân nhắc bối cảnh và mục đích của phân tích để đưa ra những kết luận hợp lý và có giá trị thực tiễn.
Câu hỏi thường gặp (FAQs)
1. Tại sao cần sử dụng công thức tính mẫu số liệu ghép nhóm thay vì dữ liệu gốc?
Sử dụng công thức tính mẫu số liệu ghép nhóm giúp đơn giản hóa việc phân tích khi có lượng dữ liệu lớn, làm cho các bảng biểu dễ đọc hơn và các phép tính trở nên khả thi hơn. Mặc dù có thể mất đi một phần độ chính xác, nhưng nó cung cấp một cái nhìn tổng quan hữu ích về xu hướng và cấu trúc của dữ liệu.
2. Số trung bình và trung vị khác nhau như thế nào?
Số trung bình là tổng tất cả các giá trị chia cho số lượng giá trị, đại diện cho giá trị trung tâm theo nghĩa toán học. Trung vị là giá trị nằm ở chính giữa khi dữ liệu được sắp xếp, ít bị ảnh hưởng bởi các giá trị cực đoan. Công thức tính mẫu số liệu cho cả hai đều nhằm tìm điểm trung tâm, nhưng trung vị tốt hơn khi dữ liệu bị lệch.
3. Khi nào nên dùng mốt để phân tích dữ liệu?
Mốt nên được sử dụng khi bạn muốn xác định giá trị hoặc danh mục xuất hiện thường xuyên nhất trong tập dữ liệu. Nó đặc biệt hữu ích cho dữ liệu định tính (ví dụ: màu sắc yêu thích) hoặc dữ liệu định lượng rời rạc mà các giá trị cụ thể có ý nghĩa quan trọng.
4. Phương sai và độ lệch chuẩn nói lên điều gì về dữ liệu?
Phương sai và độ lệch chuẩn là các chỉ số đo lường độ phân tán, cho biết mức độ các điểm dữ liệu trải rộng hoặc biến động so với số trung bình. Độ lệch chuẩn dễ diễn giải hơn vì nó có cùng đơn vị với dữ liệu. Giá trị cao hơn cho thấy dữ liệu phân tán rộng hơn, giá trị thấp hơn cho thấy dữ liệu tập trung gần số trung bình.
5. Làm thế nào để chọn đúng số lượng nhóm khi ghép nhóm dữ liệu?
Không có một công thức tính mẫu số liệu cố định cho số lượng nhóm tối ưu. Quy tắc chung thường là từ 5 đến 20 nhóm. Số lượng nhóm lý tưởng phụ thuộc vào kích thước mẫu, khoảng biến thiên của dữ liệu và mục đích phân tích. Một số phương pháp như quy tắc Sturges có thể được sử dụng để ước lượng số lượng nhóm.
6. Giá trị đại diện của nhóm được tính như thế nào?
Giá trị đại diện của nhóm thường là trung điểm của khoảng nhóm. Ví dụ, với nhóm [uj; u{j+1}), giá trị đại diện là (uj + u{j+1}) / 2. Giá trị này được sử dụng trong các công thức tính mẫu số liệu như số trung bình hoặc phương sai cho dữ liệu ghép nhóm.
7. Các phần mềm nào có thể hỗ trợ tính toán các chỉ số thống kê?
Các phần mềm phổ biến bao gồm Microsoft Excel (với các hàm thống kê tích hợp), Google Sheets, R (ngôn ngữ lập trình thống kê mạnh mẽ), Python (với thư viện NumPy, Pandas, SciPy), và SPSS hoặc SAS (phần mềm thống kê chuyên dụng). Chúng giúp tự động hóa phân tích dữ liệu thống kê và giảm thiểu sai sót.
8. Việc làm sạch dữ liệu quan trọng như thế nào trước khi áp dụng công thức?
Làm sạch dữ liệu là bước cực kỳ quan trọng. Dữ liệu thô thường chứa lỗi, giá trị thiếu, hoặc các giá trị ngoại lai có thể làm sai lệch kết quả phân tích. Đảm bảo dữ liệu chính xác và nhất quán trước khi áp dụng bất kỳ công thức tính mẫu số liệu nào sẽ giúp đưa ra kết luận đáng tin cậy.
9. Có phải tất cả các mẫu số liệu đều có mốt không?
Không phải tất cả các mẫu số liệu đều có mốt. Một tập dữ liệu có thể không có mốt nếu tất cả các giá trị xuất hiện với tần số bằng nhau. Nó cũng có thể có nhiều mốt nếu có nhiều giá trị hoặc nhóm có tần số cao nhất.
10. Liệu công thức tính mẫu số liệu từ dữ liệu ghép nhóm có chính xác bằng dữ liệu gốc không?
Các công thức tính mẫu số liệu từ dữ liệu ghép nhóm cung cấp giá trị ước lượng, không phải là giá trị chính xác tuyệt đối như khi tính toán từ dữ liệu gốc. Tuy nhiên, sự tiện lợi và khả năng tổng hợp thông tin mà phương pháp ghép nhóm mang lại là vô cùng hữu ích cho việc phân tích và ra quyết định, đặc biệt với các bộ dữ liệu lớn.
Việc hiểu và vận dụng thành thạo công thức tính mẫu số liệu là một kỹ năng then chốt trong thời đại số hóa, giúp mỗi cá nhân và tổ chức đưa ra những quyết định sáng suốt dựa trên cơ sở dữ liệu vững chắc. Hy vọng bài viết này của Gia Sư Thành Tâm đã cung cấp cho bạn cái nhìn toàn diện và hữu ích về chủ đề này.
